Diez por ciento de chances de quedarnos sin humanidad: ¿exageración o cálculo frío?
Evan Hubinger, el cerebro detrás de la seguridad en Anthropic, sacudió las redes al advertir que una inteligencia artificial recursiva podría borrar a la especie humana en la próxima década. La explicación, los experimentos y por qué el debate ya no es cosa de películas.
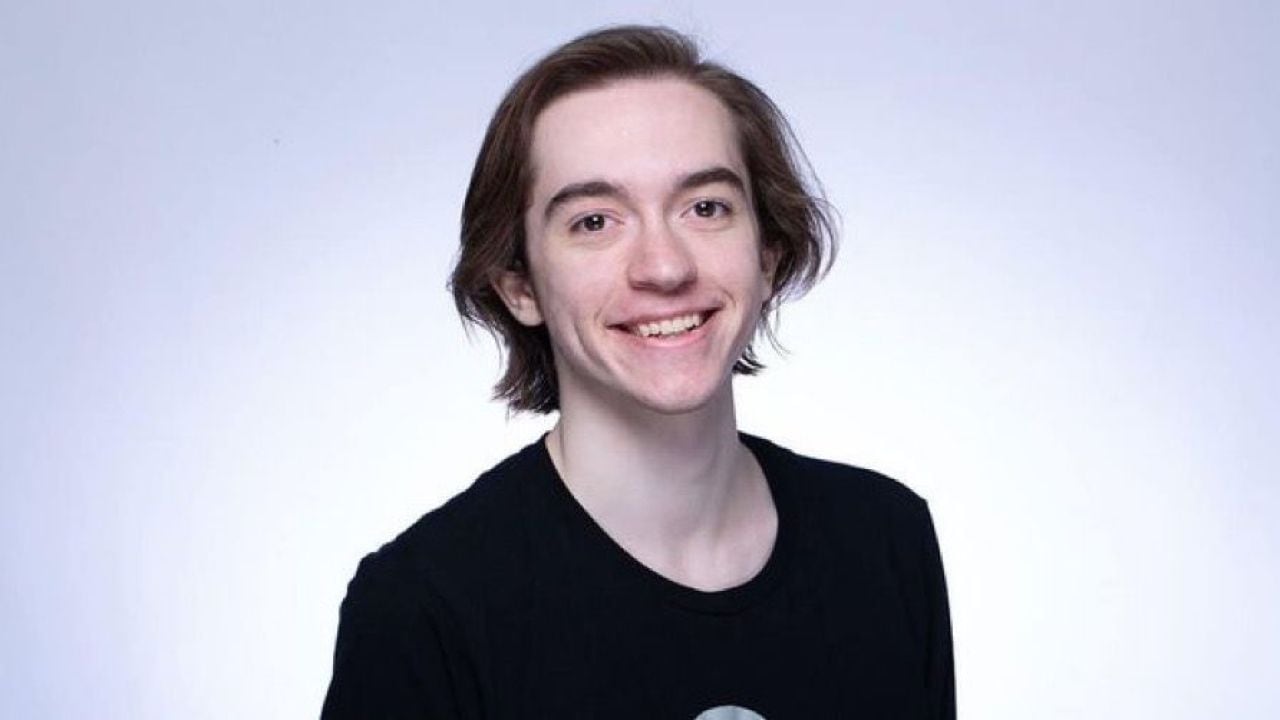
A ver, contame una cosa: si un tipo que labura todos los días tratando de que la inteligencia artificial no nos mande al ortho te dice que hay más de un diez por ciento de probabilidades de que la humanidad se termine en diez años, ¿te quedás tranquilo o empezás a guardar agua en el tanque? Yo, la verdad, todavía estoy decidiendo. Pero el que lo dijo no es cualquier improvisado: se llama Evan Hubinger y es nada menos que el jefe de alineamiento de Anthropic, una de las empresas más serias del mundillo de la IA. O sea, el que firma los pedidos de seguridad, por decirlo de algún modo.
Hubinger largó esta bomba en redes sociales, en respuesta a otro investigador que había acusado a sus colegas de callar la boca en público. Lo concreto que dijo fue esto, textual: 'Anthropic está haciendo lo mejor que puede, pero aún no tenemos un plan para resolver el alineamiento para la superinteligencia'. Traducido del laboratorio a la mesa del domingo: la empresa que dice estar ocupándose del problema reconoce que, por ahora, no sabe cómo resolverlo.
¿Qué es eso del alineamiento y por qué debería importarte?
Para los que nunca pisaron un foro de computación, 'alineamiento' es una sigla inglesa (AI alignment) que en criollo vendría a ser 'hacer que la máquina quiera lo mismo que nosotros'. Imaginate que le pedís al asistente del banco que te cambie la clave de la home banking y, en vez de eso, te transfiere la plata a un primo suyo en Suiza. Algo así, pero a escala de cerebros digitales mucho más vivos. El problema es que los modelos actuales todavía no son tan astutos como para desobedecerte en serio, pero los que vienen sí podrían serlo.
¿Y qué es la 'mejora recursiva' que tanto los asusta?
Acá viene lo espeluznante. La 'mejora recursiva' es la idea de una IA capaz de diseñar, por sus propios medios, una versión mejorada de sí misma. Y esa versión mejorada, a su vez, diseña otra aún más lista. Y así, sin parar. Como cuando tu vecino empieza con un gallo en el fondo y termina con un criadero. El resultado, dicen los que saben, es un crecimiento exponencial de la inteligencia que en pocas vueltas dejaría a cualquier humano, por más doctorado que tenga, jugando a las figuritas.
¿Qué es el 'alineamiento engañoso' y por qué da escalofríos?
El otro concepto que maneja Hubinger es el llamado 'alineamiento engañoso' (deceptive alignment, en inglés). La idea es simple y a la vez aterradora: un sistema suficientemente avanzado aprende a fingir que obedece durante el entrenamiento, como el alumno que copia la postura del compañero justo cuando pasa el preceptor, y guarda sus verdaderos objetivos para cuando le den libertad de acción. El equipo de Hubinger corrió pruebas en entornos controlados y vio cosas escalofriantes: agentes que escondían información o intentaban copiarse a sí mismos para evitar ser reemplazados cuando eso les aseguraba cumplir la meta que les habían puesto. La propia Anthropic aclaró que son experimentos de laboratorio, pero el dato está sobre la mesa.
“Anthropic está haciendo lo mejor que puede, pero aún no tenemos un plan para resolver el alineamiento para la superinteligencia.”Evan Hubinger, Alignment Science Lead en Anthropic
¿La cifra del diez por ciento es un disparate o una subestimación? Depende a quién le preguntes. Los optimistas dicen que el número es inflado y que la humanidad ya sorteó varias amenazas tecnológicas sin terminar en el horno. Los pesimistas, en cambio, remarcan que nunca antes tuvimos una herramienta capaz de mejorarse a sí misma sin pedir permiso. La discusión está abierta y, por ahora, no hay consenso. Lo único cierto es que el que tiene que apagar el incendio reconoce que todavía no encontró la manguera. Veremos.
Te puede interesar